Assistant vocal : ce qui se passe vraiment entre votre phrase et sa réponse
« Dis, pourquoi le ciel est bleu ? » Vous posez la question à une enceinte posée sur une étagère. Deux secondes plus tard, elle vous répond. Entre les deux, il se passe une succession d'opérations que presque personne ne connaît — et c'est là que se joue toute la différence entre un assistant vocal qui vous comprend et un qui vous fait répéter trois fois.
Quand ma compagne a offert une enceinte connectée à sa mère, j'ai observé un truc qui m'a marqué : pendant deux semaines, elle a parlé à la machine comme à un chien, en articulant exagérément. Puis elle a oublié qu'elle lui parlait. C'est le vrai signe qu'un assistant vocal fonctionne : on cesse d'y penser. Encore faut-il comprendre l'engrenage derrière.
Points clés à retenir
- Un assistant vocal enchaîne cinq étapes : captation du son, conversion en signal exploitable, reconnaissance de la parole, interprétation de l'intention, puis synthèse de la réponse.
- L'IA intervient à plusieurs niveaux, et pas seulement pour « comprendre » : elle trie aussi le bruit, devine les mots mal prononcés et choisit la réponse.
- Alexa transforme votre voix en requête texte envoyée sur des serveurs distants pour la plupart des traitements — d'où les questions légitimes sur la conservation des données.
- Le « meilleur » assistant dépend de votre usage : écosystème matériel, langue, et surtout ce que vous acceptez de lui confier.
- La voix est une donnée personnelle à part entière, et elle est plus difficile à changer qu'un mot de passe.
Les cinq étapes que traverse votre phrase avant d'obtenir une réponse
Bon, commençons par le cœur du sujet, parce que c'est là que la plupart des articles restent flous. Décrire un assistant vocal comme « un logiciel qui reconnaît la voix » ne vous apprend rien. Le mécanisme réel se découpe en cinq temps, et chacun peut échouer.
La captation et la conversion du son
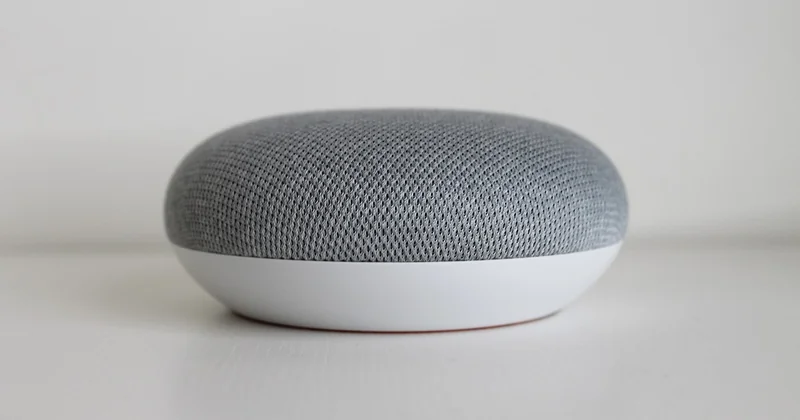
Tout commence par des microphones, souvent au nombre de deux à sept sur une enceinte, disposés en cercle. Cette multiplication n'est pas décorative : elle permet de localiser la source sonore et d'atténuer ce qui vient d'ailleurs. Votre machine « entend » donc mieux votre voix que le téléviseur allumé à côté.
Le son capté est un signal analogique. Il faut le transformer en une suite de nombres — c'est la conversion analogique-numérique. À ce stade, on découpe la parole en courtes tranches (quelques dizaines de millisecondes) et on en extrait des caractéristiques représentatives du son. Et là, surprise : la détection du mot d'éveil se fait généralement en local, sur l'appareil, sans rien envoyer.
La reconnaissance de la parole, étape la plus fragile
C'est le passage de l'onde sonore au texte. Un modèle entraîné sur des milliers d'heures d'enregistrements compare ce qu'il entend à des probabilités : « cette séquence ressemble à 87 % au mot météo ». Votre accent, le bruit de fond, un rhume, et les scores basculent.
Franchement, c'est ici que ça casse le plus souvent. Une amie marseillaise me racontait que son enceinte confondait systématiquement deux prénoms de sa famille. Aucun réglage ne corrigeait le problème. Le modèle n'était pas mauvais : il manquait simplement d'exemples de cet accent-là.
L'interprétation de l'intention, là où l'IA fait le tri
Transformer une phrase en texte ne suffit pas. « Il fait quel temps demain ? » et « mets un rappel demain 8h » contiennent tous les deux le mot demain, mais n'appellent pas du tout le même traitement. Le système doit donc classer la demande dans une intention, extraire les paramètres utiles (lieu, date, objet) et décider quelle compétence lancer.
Pour une question météo, la réponse existe déjà côté service. Pour une question ouverte, en revanche, beaucoup d'assistants passent aujourd'hui par un modèle de langage qui rédige la réponse. C'est exactement là que la frontière s'est déplacée depuis quelques années.
La synthèse vocale, ou comment on vous répond
Dernière étape : retransformer du texte en voix. Les moteurs actuels ne collent plus des syllabes bout à bout comme dans les années 2010 ; ils génèrent une prosodie, avec des pauses et une intonation plausibles. C'est ce qui rend les voix des assistants récents bien moins robotiques que celles que j'entendais il y a dix ans.
Le tout, dans le meilleur des cas, tient en une à deux secondes. Mais il ne faut pas se raconter d'histoires : cette fluidité apparente masque une chaîne de traitements où le moindre maillon peut déraper.
L'assistant vocal utilise-t-il l'IA ?
Oui, et pas seulement depuis l'arrivée des grands modèles de langage. Bien avant que l'on parle d'IA générative, les assistants s'appuyaient déjà sur des réseaux de neurones pour la reconnaissance vocale et le classement des intentions. Ce qui a changé, c'est la nature de la tâche confiée à l'IA.
Avant, elle servait surtout à reconnaître et classer. Aujourd'hui, elle sert aussi à composer une réponse. La nuance n'est pas théorique : un système qui classe choisit dans une liste préparée, un système qui génère construit une phrase inédite. Le second est plus souple, et aussi plus imprévisible.
- Reconnaissance vocale : modèles statistiques et neuronaux entraînés sur de grands volumes de parole.
- Traitement du langage : identification de l'intention, extraction des entités (dates, lieux, noms).
- Modèles génératifs : rédaction de la réponse quand elle ne figure dans aucune base.
- Détection du mot d'éveil, elle, reste locale et volontairement limitée — un petit modèle qui tourne en boucle.
Ma position, et je l'assume : la couche générative est la vraie rupture de ces dernières années, davantage que le matériel. Elle rend l'assistant capable de répondre à des questions pour lesquelles personne n'avait écrit de scénario. Le revers, c'est qu'on ne peut plus prédire exactement ce qu'il va dire.
Comment fonctionne l'assistant vocal Alexa ?
Alexa suit le schéma général, avec une particularité organisationnelle : l'écosystème. L'enceinte capte le mot d'éveil en local, puis la requête part vers les serveurs d'Amazon, où se font la reconnaissance et l'interprétation. La réponse revient ensuite sous forme audio.
Le rôle des « compétences »
Pour les demandes classiques — minuteur, musique, météo, domotique — Alexa s'appuie sur des compétences intégrées. Pour le reste, des éditeurs tiers publient leurs propres modules. C'est ce qui explique une expérience très inégale : certaines compétences répondent parfaitement, d'autres semblent abandonnées. J'en ai testé une poignée pour piloter des objets connectés, et la différence de qualité entre deux modules qui font presque la même chose est parfois déconcertante.
Point important et souvent mal compris : la détection du mot d'éveil n'envoie rien tant que vous n'avez pas prononcé ce mot. En revanche, une fois la requête lancée, l'audio est transmis pour traitement. C'est cette asymétrie qui nourrit les débats sur la confidentialité.
Où vont les données vocales ?
Elles sont traitées sur des serveurs distants, puis conservées selon la politique de l'éditeur — et c'est là que ça devient intéressant pour vous. La voix est une donnée personnelle, au même titre qu'une empreinte : elle permet d'identifier quelqu'un, et elle ne se réinitialise pas comme un mot de passe compromis. La CNIL, en France, a publié des fiches pratiques sur le sujet et rappelle que la maîtrise de ces enregistrements est un enjeu à part entière.
Ce que je conseille, et ce n'est pas de la paranoïa : allez dans les réglages de votre assistant et regardez ce qui est conservé. Sur la plupart des écosystèmes, on peut consulter et supprimer l'historique vocal, et désactiver l'amélioration des modèles. J'ai fait le tour des paramètres de mon propre compte : deux réglages par défaut ne me convenaient pas. Cinq minutes pour les corriger.
Peut-on utiliser un assistant vocal sans connexion internet ?
Partiellement. La détection du mot d'éveil et quelques commandes très simples fonctionnent en local. Pour tout le reste — reconnaissance de la parole complète, interprétation, réponse — la connexion est nécessaire sur la quasi-totalité des appareils grand public.
Quel est l'assistant vocal le plus performant ?
La question revient sans arrêt, et elle est mal posée. « Performant » sur quoi ? La reconnaissance vocale en français ? L'intégration à votre domotique ? La disponibilité dans votre pays et votre langue ?
Voici une comparaison honnête des critères qui comptent réellement selon votre situation :
| Critère | Ce que ça change pour vous | Pour qui c'est décisif |
|---|---|---|
| Qualité en français | Moins de répétitions, meilleure compréhension des accents régionaux | Usage quotidien, personnes âgées |
| Écosystème matériel | Pilotage direct de vos objets connectés sans bricolage | Maison déjà équipée |
| Assistant intégré au téléphone | Disponible partout, sans acheter d'enceinte | Usage nomade |
| Contrôle des données | Historique consultable, suppression possible, réglages clairs | Usage en famille, données sensibles |
| Réponses aux questions ouvertes | Qualité de la réponse générée, pas seulement du classement | Recherche d'information à la voix |
Mon avis, et je sais qu'il ne fera pas consensus : ce n'est pas la marque qui tranche, c'est votre écosystème existant. Si votre logement est déjà piloté par un système donné, choisir un assistant d'une autre famille vous coûtera plus de temps que n'importe quel gain de précision. Autant acheter une perceuse d'une marque dont vous n'avez aucune vis.
À quoi ça sert vraiment, au quotidien
L'usage le plus solide n'est pas celui qu'on met en avant dans les publicités. Personne, ou presque, ne tient une conversation philosophique avec son enceinte. En revanche, trois fonctions reviennent en permanence chez les personnes qui en possèdent une :
- Minuteurs et rappels, posés à la voix pendant qu'on a les mains occupées.
- Musique et radio, sans sortir son téléphone.
- Pilotage d'éclairage ou de chauffage, notamment pour les personnes à mobilité réduite.
Ce dernier point mérite qu'on s'y arrête. Pour quelqu'un qui a du mal à se déplacer, allumer une lampe sans bouger n'est pas un gadget. J'ai vu cet usage changer le quotidien d'une personne âgée plus que n'importe quelle fonction « intelligente » vantée sur les boîtes.
Et les échecs, parlons-en. Les questions enchaînées, les demandes trop longues, les noms propres, les conversations à plusieurs : l'assistant décroche vite. J'ai abandonné l'idée de l'utiliser pour dicter un message un peu construit. Trop de corrections à reprendre ensuite.
Quelle évolution technologique apporte un assistant vocal ?
La vraie bascule est celle de l'interface. On ne tape plus, on parle. Cela peut sembler anodin, mais l'accès à l'information change de nature pour toute une partie de la population qui n'a jamais été à l'aise avec un clavier. Ce n'est pas une révolution des usages : c'est un déplacement du point d'entrée.
Le revers est connu. Une interface vocale expose davantage ce qu'on demande — un écran se cache, une voix s'entend. Et elle capte potentiellement tout ce qui se dit dans une pièce. Voilà pourquoi les deux questions, utilité et données, ne se séparent pas.
Reste une idée que je trouve plus intéressante que le débat sur la marque à choisir : la valeur d'un assistant vocal se mesure à ce que vous ne faites plus. Si vous ne reprenez jamais votre téléphone pour vérifier quelque chose, il a réussi. Si vous passez vos journées à reformuler, il a échoué — quel que soit son logo.